OpenTelemetry 留下了订单 Trace,支付失败的 span 去哪了?
文章目录
订单服务隔几天出现一次超时。追踪后端里能搜到入口请求,也有数据库调用,却找不到支付服务记录的那个错误 span。故障真正发生在支付侧,证据却只到数据库。若多个 Collector 采样副本随意分流,入口和支付 span 可能根本没有到同一台机器。每台 Collector 看到了不同故事,规则都照常执行。
尾部采样在接收了一部分或完整的 span 后决定要不要保留。它能让错误、长延迟和少量正常请求共存,在故障期间留下高价值样本。它要用内存和时间交换这份判断能力。下面按一个虚构的订单链路拆开部署。
让同一条 Trace 先走到同一个决定点
接收层对客户端开放,由负载均衡导出器按 trace ID 路由。采样层收到 span 后聚合,作出保留决定,再向追踪存储导出。别把接收层和采样层都丢给彼此独立的轮询。无论调用发生在哪里,采样层需要能够拼到同一追踪。应用 SDK 如果先扔掉大部分追踪,后端无法补回。清点每种语言的 SDK、传播配置和中间 Collector,把入口到支付的上下文贯通作为部署前的检查。
订单 API   ┐
支付服务   ├→ Collector 接收层 → 按 trace ID → Collector 采样层 → 追踪存储
库存服务   ┘
采样层实例改变,路由映射也可能改变。一条追踪正在跨服务运行时,后来的 span 落到另一实例,就会部分丢失;新请求不一定受同样影响。于是扩缩容测试要看变更前后的一段连续流量,不要只在节点添加后等待五分钟,再测一条立即结束的请求。
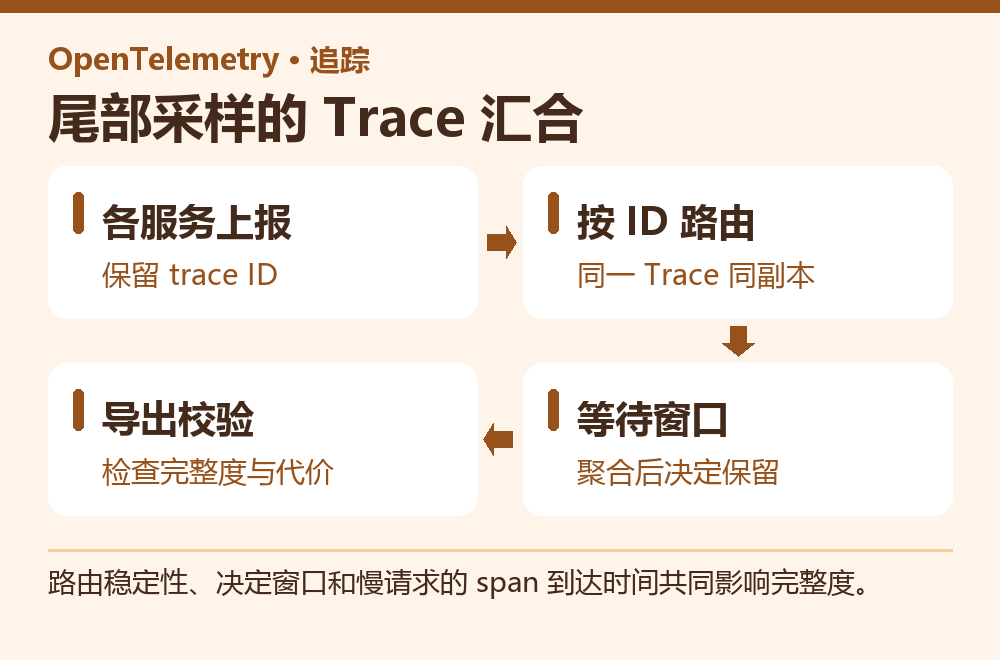
路由稳定性、决定窗口和慢请求的 span 到达时间共同影响完整度。
先把实时内存账算一遍
假设每秒开始 600 条追踪,等待 15 秒再决定。在稳定条件下,尚未决定的追踪数量约为 9000。这个估数只到订单量级:实际还要考虑每条 Trace 的 span 数和属性大小,有的跟踪只有几段,有的带几百条批处理事件。为选定的 Collector 配置测试峰值 RSS、决策容量、内存限制和导出队列。比如一段流量加倍,等待时间不变,数量能到 18000,还没算前期积压。如果选择把决定窗口增到 30 秒来保留慢依赖,内存预算要按新的数量重算。
决定等多长,最好用同一 Trace 首尾 span 在采样层的到达时间差推导。长任务可能把支付错误拖到根 span 之后很久才上报。晚到 span 在决定之前、之后和决定记录已过期以后,处理结果可能不同,查使用版本的行为与缓存配置。不要为了保住全部离线作业而把在线采样窗拉得很长。可先区分长任务和在线追踪的路径、策略或保留要求。
制作一条不会和生产业务混淆的晚到 Trace
在测试环境固定一个虚构订单,入口记主 span,支付请求在五秒之后再完成。把它从 Collector 接收端送进与正式策略相同的隔离数据流。对比五秒、十五秒和三十秒的决策设置,并检查后端树状视图能否看到支付错误。第二轮重启一个采样副本,捕捉更换副本时哪些 trace 进入不完整状态。为演练设置自有资源或追踪标签,在仪表盘里过滤出去,免得拿合成的错误衡量真实服务。这样能把规则与部署生命周期分别验证。
再做一个导出被阻塞的场景,例如测试后端暂时不接收。在接收层查看收到了多少 span,在采样层核对作出「保留」决定的数量,在导出端检查队列与失败。若只有后端条数变小,通常不应扩大采样容量来解决。若入口实际就少了一批 span,先看 SDK 上游的丢弃、采样及传播。对比多个观测点时,用固定 trace ID 的样本配合计数器,避免把某次指标重启后的零值当成永久丢失。
保存平时和故障时的采样配置及 Collector 版本。当前决定逻辑随着配置更新可能改变。出现紧急故障时,要知道是否能临时额外保留一小类追踪、这个选择需要增加多少内存,以及结束后如何恢复原策略。
如果使用有状态策略和当班人维护的例外规则,改规则后别只测试会命中的错误。顺便发一条格式接近但不应保留的请求,检查标签、匹配条件与采样决策。部署可以给采样策略一个专用环境标记,先只作用于合成与测试流量。这样探针不会抬高生产后端的错误比例,也不会让实验消耗覆盖实际故障证据。
给三条请求贴标签,从入口追到最终存储
测试请求一是成功短路径,二是下游明确失败,三是根 span 已结束后再发一个重要的晚到 span。记录每条追踪应该有的 span 数、哪些决定是否保留,再在接收层、采样层和后端核对。如果采样层说已经保留,但后端缺关键 span,应转查导出队列、批处理、迟到规则或后端丢弃。若采样层根本没看到错误,就回到前面的路由与传播。
上线先匹配少数高价值错误或慢请求,再确保常规流量随机保留一定份额,留一条可以比较的背景。请用指标管道统计整体错误率,从被保留的 Trace 直接估算会偏向规则倾向保留的错误。值班人员从故障列表打开一条追踪,应该能知道是根本没采到、已经丢在边界,还是查询遗漏了。把各层失败变成可观察状态,尾部采样才会减少排障时间。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论