Node.js 26 在 amd64 能跑,为什么 arm64 镜像起不来?
文章目录
把 Node.js 从 24 升到 26,打包在开发机和 amd64 CI 都通过。准备扩大灰度才发现 arm64 镜像的一个图像依赖需要本地编译,运行时容器缺共享库。就算临时补齐这个库,还有另一个问题:图像接口在峰值时变慢,到底是原生依赖、事件循环,还是图片来源站点的响应慢了?这两个故障应分别归到构建和运行阶段。
Node.js 26 已进入 LTS,代号 Lithium。下面假设团队运行图片代理和常规 JSON API,目标是让两个架构都发布到受支持的分支。情境和数字是排查用示例。
先把每个待发布镜像拉起一次
只比源码提交很容易漏掉环境。为 24 和 26 各固定基础镜像摘要,记录 npm 版本、锁文件提交、目标架构和 libc。安装用 npm ci 从固定锁文件恢复。将构建制品复制进实际运行镜像,在里面运行最小脚本,导入图片、压缩和加密等带原生扩展的依赖。测试要覆盖一次真正走到原生路径的函数调用:有些包导入时并不加载目标二进制,直到第一次处理文件才会报错。
Node-API 提供一定范围内的 ABI 稳定性,仍要看依赖使用了哪一层 API。Node-API 包不自动意味着换了架构、libc 或外部共享库也可直接复用。记录安装拿到的是预构建包还是本地编译产物。CI 成功但运行镜像失败时有两份现场证据,不必反复改源码猜。
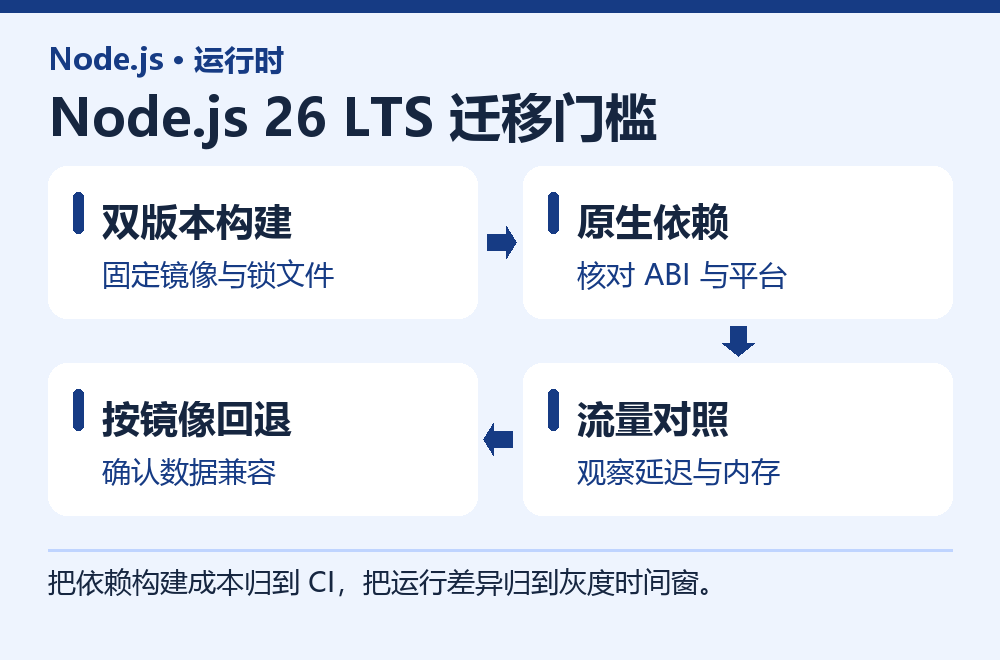
把依赖构建成本归到 CI,把运行差异归到灰度时间窗。
把发布失败拆成开发机能复现的两层
当安装日志回落到源码编译时,做一个最小容器实验。第一层只负责按锁文件安装,保存安装阶段的架构、平台和包版本。第二层使用和生产一样的精简镜像,只复制最终应用与依赖,尝试加载、解码一个很小的测试图。第一层成功、第二层失败时,优先排共享库、文件权限和构建产物路径,别把构建镜像整个搬进运行时以图省事。这样可能掩盖问题,还让基础镜像变大,缓存和发布耗时一起改变。两层都成功,再用同一个镜像跑完整应用的 smoke test。
稳定性报告至少给每个架构留一行。同样的 Node 版本下,依赖可能为一种架构提供预构建,而对另一种架构现场编译。CI 如果安装时落在开发机架构,复制 ‘node_modules’ 则会把误配直接带到生产。检查运行容器实际报告的 ‘process.arch’、镜像平台和依赖路径。保存临时新增的系统依赖说明,避免半年后升级镜像时又重新踩坑。
有个迁移判据比「新版本快了几个点」实用:在全部生产架构上同一构建任务可以独立重做,灰度出现问题时旧摘要在镜像仓库里还存在,旧版本对灰度中的新记录仍能正确操作。达到这三项后,发布团队才能在高峰时真正按预案撤回。
另留一条能重放的图像输入,从最容易暴露差异的地方开始,例如曾经出错的特定编码格式。验证解码后的尺寸和输出类型,再分别统计冷启动后的首答和连续调用。两个版本都返回 200,但其中一个落到另一条降级路径时,P99 的差异属于依赖行为。通过把样本、镜像和应用记号放到同一份记录,测试人员可以在不连线上服务的前提下查清原因。
图像请求变慢时,先把时间线分成两段
用同量同构的负载同时打到 24、26 两组实例。选择相同连接复用、请求大小和缓存状态。对照组不要和候选组争用过小的下游连接池,可用同条件的独立实例或严控下游容量。两边都记录路由 P95、P99、进程 RSS、CPU 节流和事件循环延迟。下面的 Node.js 探针每十秒读一次累计区间,并把纳秒改成毫秒。
import { monitorEventLoopDelay } from 'node:perf_hooks';

const loop = monitorEventLoopDelay({ resolution: 20 });
loop.enable();

setInterval(() => {
  console.log({
    eventLoopP99Ms: loop.percentile(99) / 1e6,
    rssMiB: process.memoryUsage().rss / 2 ** 20,
  });
  loop.reset();
}, 10_000).unref();
测量分辨率不等于业务阈值。以两个版本的同配置直方图做比较,避免不同观察方式本身造成差异。示意场景里,图片路由的 P99 多了 180 ms,事件循环延迟几乎没变,外部图片获取的等待却多了 170 ms。这时查 DNS、连接复用和下游队列,比盯着 V8 有效。如果事件循环尖峰、RSS 增长和容器节流同时出现,则把注意力转到同步编码、GC 或 CPU 配额。逐步减去已知下游耗时,才能知道该向哪一层要证据。
冷启动也算在发布成本里
启动阶段加载原生模块、建立连接池和首个图像请求的缓存都可能变化。记录容器创建到 readiness,再记录首次代表性请求完成的时间。一个持续运行十天的进程和按需伸缩的服务,对头几秒开销有不同容忍度。旧版与新版各重启数次,所得差异比连续打一个进程更能说明冷启动。
灰度按实际架构分别推进。先让小比例稳定流量经过,覆盖至少一个真正的高峰。对正在处理的请求要留出正常退出窗口,长连接用原有排空机制。回退时部署已验证的旧摘要,别把一个可漂移的标签当成旧版本。运行时升级期间把破坏性数据格式变化留到独立变更;重新连上旧镜像却读不了灰度期产生的记录,说明回退演练漏了业务读写。
最终发布记录写清两份镜像从哪里来、原生依赖怎样装、当前观察的是哪一段时间。下一次生产异常可以从这一页开始,不用先重新考古 npm 日志。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论