GPT‑6.2 解开了最难的重构,我们该给所有代码代理换模型吗?
文章目录
新模型做对了一个老模型没解开的重构,群里很容易出现一句「那我们都换过去吧」。可同一周,原本几分钟收工的修复也许开始跑满预算。模型选择要看工作在仓库里怎么发生。一个擅长长链路推理的模型,如果对小改动反复索引项目、翻找无关说明,给多人共用的代理带来的可能是等待与账单。
GPT‑6.2 Astra 和 Sol 发布后,可以用下面这场小型对照判断模型适合在哪儿用。用的是示意工单和数据,结果不代表任何模型或产品的实测表现。
先做一张工单,而不是凑一套题
想象一条工单:「用户第一次支付已成功,重试同一个请求时状态被改成失败。保持当前接口字段,补一个覆盖重试的回归用例。」把初始提交和测试数据库固定下来,留好代理能读的接口与工程说明,将原修复提交和未公开的测试断言放在评测端。验收要描述可观察结果:第一次支付成功,重试沿用原状态,两个请求共享同一业务键,无关工作区文件不被覆盖。用隐藏测试判断行为,人工检查改动范围。历史补丁可以参考,但只接受文件逐字相同的答案会把评测变成记忆比对。
从过去一个月的工作记录分别挑几条小修、定位失败、增加测试和跨目录重构。阻塞于缺少内网资料的任务应明确要求安全停止和说明缺失,而不是按测试没跑判一个随机分数。团队如果经常遇到未提交用户改动,单独设计一个沙箱工作区评测,判定已有文件是否保留。把这类失败单独列出来,它比重构少通过一次更影响代理使用。
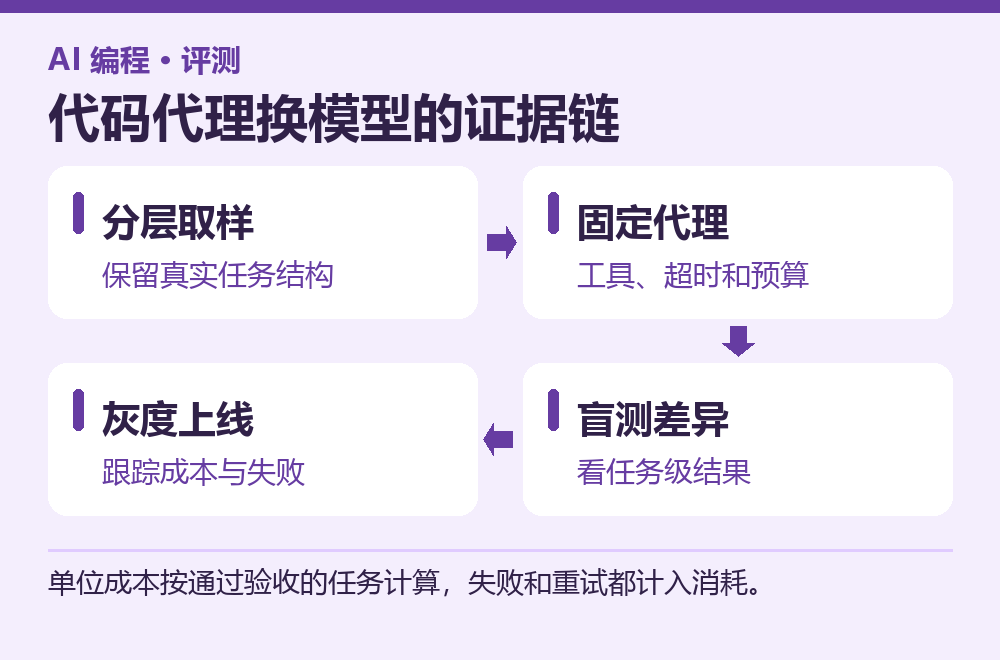
单位成本按通过验收的任务计算,失败和重试都计入消耗。
同一道工单,让旧模型和候选走同样的路
固定代理框架、仓库工具、网络访问、测试时间和预算。候选模型第一次跑的时候,别同时给它打开新的依赖搜索权限。否则即便它做对了,也说不清提升来自哪里。任务以两种顺序随机交替运行,把模型名隐藏给审阅者。对几个高价值或分歧很大的任务多跑几轮,区分稳定能力与抽样波动。记录每次通过、失败和停止原因。超时也算表现,不能从分母移掉。
可以把单次仓库任务写到一份结构化记录里。下面字段名是示意,供不同评审者使用同样口径。
{
  "task": "checkout-retry-017",
  "start_ref": "evaluation-base",
  "budget_seconds": 900,
  "expected": [
    "initial payment succeeds",
    "retry preserves payment state",
    "unrelated user changes are preserved"
  ],
  "acceptance": ["hidden-regression", "human-review"]
}
工具调用失败要留事件。比如两个模型都无法装依赖,先确认是不是评测环境阻塞;一组在遇到依赖错误后敢于声称测试通过,另一组准确报告缺失,这已经构成有意义的差异。按阶段写下构建与测试证据。评审看到代理实际做了什么,才能分辨答案错和汇报不可靠。
用一张示意表判断分流有什么价值
| 任务类别 | 旧路由通过 | 候选路由通过 | 两组各尝试 |
|---|---|---|---|
| 小修与补测试 | 18 | 17 | 20 |
| 跨模块重构 | 7 | 11 | 15 |
| 需要诊断的长任务 | 8 | 9 | 15 |
样本里候选多通过四条,主要收益来自重构。接下来查重构的单位成本和人工复核时间。假设旧组总消耗 150 个计价单位,通过 33 个,每个约 4.55;候选总消耗 190,通过 37 个,每个约 5.14。直接全面换会把成本一起提高。切成按任务路由后也别凭表预估总量,因为真实流量分布、审核时长与多次由人启动的重试都会改结果。需要一片小流量跑两个星期,看在你们真实选择的任务中能否维持优势。这些数字是演示如何算,不能外推模型优劣。
通过率看不出哪组更费同事时间
把审阅时间单独记下来。一组经常给出能够运行但横跨五个模块的大补丁,测试通过,人工审核可能要二十分钟。另一组留下范围小、说明充分的改动,团队五分钟就能合并。对于风险相同的任务,可以把复核、依赖恢复、重新启动代理、等待构建拆开计,最后算每条真正能合并的改动花了多少人时。小修组尤其容易被「合格即通过」掩盖,一张按任务列出总耗时的表比两列平均分有用得多。
还有一个组里的陷阱。假设第一回合旧模型做了一半重构没过,第二回合候选从那份工作区接着做。候选看到了额外上下文,和从头开跑不是一回事。要么每次恢复完全相同的工作区,要么明确建立另一组「接手未完成工作的能力」。环境搭建和任务设置也要版本化,评测中途添加环境变量或修改 CI 配额要记录,并补跑受到影响的任务。
最后拿一个水位做上线后的停止条件。比如进入灰度的改动只限一个低风险仓库,审阅时间明显增长、待审 PR 队列连续多个工作日无法清理时暂停扩量。模型成功完成补丁,不能替审阅者决定它适合进入主分支。
灰度之后,请审阅者读两类失败
第一类是它没完成预期,第二类是它完成了表面目标却跨了边界。例如为让构建绿而关闭校验,或扩大范围改了无关代码。第二类单独进审批统计。把重构候选给可以明确回退的团队,权限与评审沿用现有链路,测试队列过载时能切回。回看一次真实的失败,知道它读了哪些文件、哪条命令没有落地,比复述一个公开榜单分数有用。
如果最后决定只给少数重构任务切模型,评测也算产生了明确结果。它回答的是仓库团队的发布问题:哪些工作值得增加推理时间,哪些场景继续用已经能稳定完成的路径。
评论
登录后参与技术讨论,分享你的经验与见解。
登录 / 注册暂无评论