38 Hadoop HA搭建
本节目录
Hadoop数据压缩
压缩基本原则
- 运算密集型的job:少用压缩
- IO密集型的job:多用压缩
MR支持的压缩编码
| 压缩格式 | hadoop自带? | 算法 | 文件扩展名 | 是否可切分 | 换成压缩格式后,原来的程序是否需要修改 |
|---|---|---|---|---|---|
| DEFLATE | 是,直接使用 | DEFLATE | .deflate | 否 | 和文本处理一样,不需要修改 |
| Gzip | 是,直接使用 | DEFLATE | .gz | 否 | 和文本处理一样,不需要修改 |
| bzip2 | 是,直接使用 | bzip2 | .bz2 | 是 | 和文本处理一样,不需要修改 |
| LZO | 否,需要安装 | LZO | .lzo | 是 | 需要建索引,还需要指定输入格式 |
| Snappy | 是,直接使用 | Snappy | .snappy | 否 | 和文本处理一样,不需要修改 |
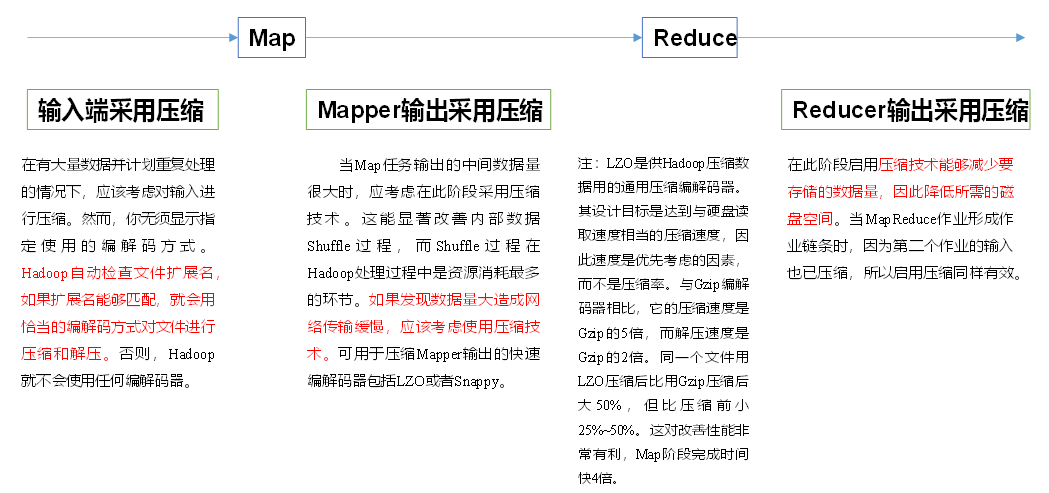
压缩位置的选择
Hadoop企业优化
MapReduce跑的慢的原因
- 计算机性能
- 数据倾斜
- Map和Reduce数设置不合理
- Map运行时间太长,导致Reduce等待过久
- 小文件过多
- 大量的不可切片的超大压缩文件
- Spill次数过多
- Merge次数过多
MapReduce优化方法
数据输入
- 合并小文件
- 采用CombineTextInputFormat来作为输出
Map阶段
- 减少溢写(Spill)次数
- 通过调整
mapreduce.task.io.sort.mb及mapreduce.map.sort.percent参数值,增大触发Spill的内存上限,减少Spill次数,从而减少磁盘IO
- 通过调整
- 减少合并(Merge)次数
- 通过调整
mapreduce.task.io.sort.factor参数,增大Merge的文件数目,减少Merge的次数
- 通过调整
- 在Map之后,不影响业务逻辑的前提下,先进行Combine处理
Reduce阶段
- 合理设Map和Reduce数
- 设置Map、Reduce共存
- 调整
mapreduce.job.reduce.slowstart.completedmaps参数 - 使Map运行到一定程度后,Reduce也开始运行,减少Reduce的等待时间
- 调整
- 规避使用Reduce
- Reduce在用于连接数据集的时候会产生大量分网络消耗
- 合理设置Reduce端的Buffer
- 默认情况下,数据达到一个阈值的时候,Buffer中的数据就会写入磁盘,然后Reduce会从磁盘中获得所有数据,消耗了IO
mapreduce.reduce.input.buffer.percent默认为0,设置大于0的值,会保存指定比例的内存将数据直接从Buffer中拿给Reduce使用
IO传输
- 采用数据压缩的方式,snappy、LZO
数据倾斜问题
- 抽样个范围分区
- 自定义分区
- Combiner
- 采用Map Join,尽量避免Reduce Join
Hadoop新特性
小文件存档
# 启动YARN进程
start-yarn.sh

# 把/user/lixuan/input目录里面的所有文件归档成一个叫input.har的归档文件,并把归档后文件存储到/user/lixuan/output路径下
hadoop archive -archiveName input.har -p  /user/lixuan/input   /user/lixuan/output

# 解归档文件
hadoop fs -cp har:///user/lixuan/output/input.har/*    /user/lixuan
回收站
core-site.xml配置垃圾回收时间为1分钟<property> <name>fs.trash.interval</name> <value>1</value> </property> <property> <name>fs.trash.checkpoint.interval</name> <value>1</value> </property>通过网页上直接删除的文件不会走回收站
通过程序删除的文件,需要调用
moveToTrash()才进入回收站Trash trash = New Trash(conf); trash.moveToTrash(path);通过命令行
hadoop fs -rm命令删除的文件会走回收站
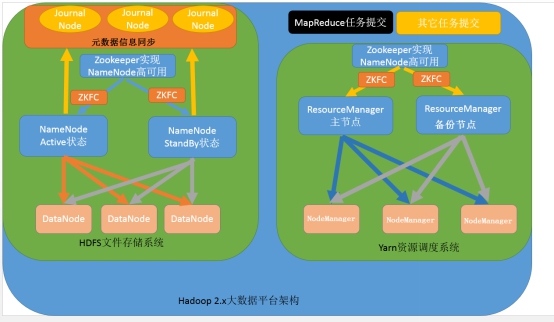
HA架构图
HDFS-HA
工作机制
- 通过多个NameNode消除单点故障
工作要点
- 元数据管理方式要改变
- 内存中各自保存一份元数据
- Edits日志只有Active状态的NameNode节点可以做写操作
- 所有的NameNode都可以读取Edits
- 共享的Edits放在一个共享的存储中管理(qjournal和NFS两个主流实现)
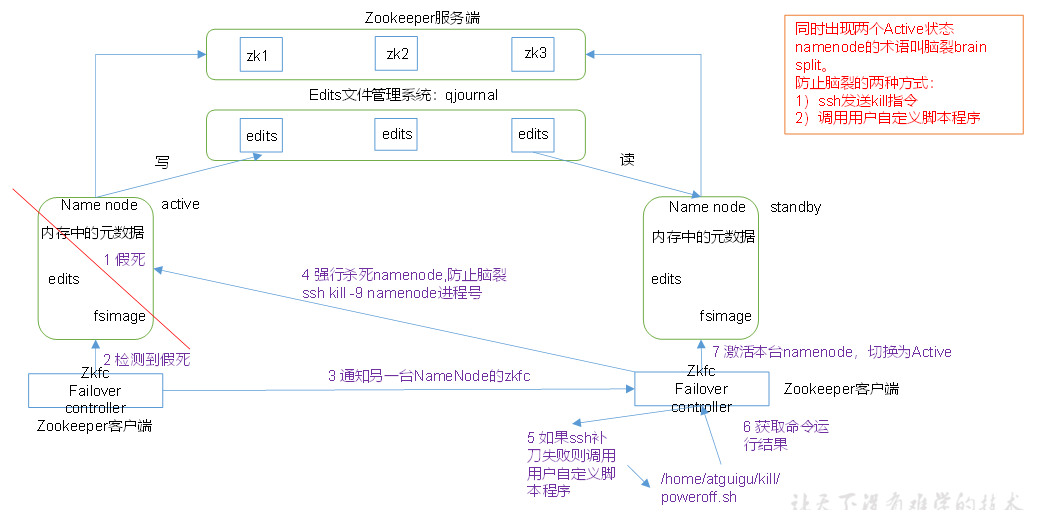
- 需要一个状态管理模块
- 利用zk进行状态标识
- 保证两个NameNode之间能够ssh无密码登录
- 隔离(Fence),同一时刻仅能有一个NameNode对外提供服务
自动故障转移机制
HDFS-HA集群配置
集群规划
| node01 | node02 | node03 |
|---|---|---|
| NameNode | NameNode | NameNode |
| ZKFC | ZKFC | ZKFC |
| JournalNode | JournalNode | JournalNode |
| DataNode | DataNode | DataNode |
| ZK | ZK | ZK |
| ResourceManager | ||
| NodeManager | NodeManager | NodeManager |
配置HDFS-HA集群
删除data和log目录
配置
core-site.xml<configuration> <!-- 把多个NameNode的地址组装成一个集群mycluster --> <property> <name>fs.defaultFS</name> <value>hdfs://mycluster</value> </property> <!-- 指定zkfc要连接的zkServer地址 --> <property> <name>ha.zookeeper.quorum</name> <value>node01:2181,node02:2181,node03:2181</value> </property> </configuration>配置
hdfs-site.xml<configuration> <!-- NameNode数据存储目录 --> <property> <name>dfs.namenode.name.dir</name> <value>file://${hadoop.tmp.dir}/name</value> </property> <!-- DataNode数据存储目录 --> <property> <name>dfs.datanode.data.dir</name> <value>file://${hadoop.tmp.dir}/data</value> </property> <!-- JournalNode数据存储目录 --> <property> <name>dfs.journalnode.edits.dir</name> <value>${hadoop.tmp.dir}/jn</value> </property> <!-- 完全分布式集群名称 --> <property> <name>dfs.nameservices</name> <value>mycluster</value> </property> <!-- 集群中NameNode节点都有哪些 --> <property> <name>dfs.ha.namenodes.mycluster</name> <value>nn1,nn2,nn3</value> </property> <!-- NameNode的RPC通信地址 --> <property> <name>dfs.namenode.rpc-address.mycluster.nn1</name> <value>node01:8020</value> </property> <property> <name>dfs.namenode.rpc-address.mycluster.nn2</name> <value>node02:8020</value> </property> <property> <name>dfs.namenode.rpc-address.mycluster.nn3</name> <value>node03:8020</value> </property> <!-- NameNode的http通信地址 --> <property> <name>dfs.namenode.http-address.mycluster.nn1</name> <value>node01:9870</value> </property> <property> <name>dfs.namenode.http-address.mycluster.nn2</name> <value>node02:9870</value> </property> <property> <name>dfs.namenode.http-address.mycluster.nn3</name> <value>node03:9870</value> </property> <!-- 指定NameNode元数据在JournalNode上的存放位置 --> <property> <name>dfs.namenode.shared.edits.dir</name> <value>qjournal://node01:8485;node02:8485;node03:8485/mycluster</value> </property> <!-- 访问代理类:client用于确定哪个NameNode为Active --> <property> <name>dfs.client.failover.proxy.provider.mycluster</name> <value>org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider</value> </property> <!-- 配置隔离机制,即同一时刻只能有一台服务器对外响应 --> <property> <name>dfs.ha.fencing.methods</name> <value>sshfence</value> </property> <!-- 使用隔离机制时需要ssh秘钥登录--> <property> <name>dfs.ha.fencing.ssh.private-key-files</name> <value>/home/lixuan/.ssh/id_rsa</value> </property> <!-- 启用nn故障自动转移 --> <property> <name>dfs.ha.automatic-failover.enabled</name> <value>true</value> </property> </configuration>将配置文件分发到其他节点
各个节点启动
journalnode服务hdfs --daemon start journalnodenn1格式化hdfs,并启动
hdfs namenode -format
hdfs --daemon start namenode
nn2,nn3上同步nn1的元数据信息
hdfs namenode -bootstrapStandby关闭所有HDFS服务
启动Zookeeper集群
zkServer.sh start初始化HA在Zookeeper中的状态
hdfs zkfc -formatZK启动HDFS服务
Yarn-HA
集群规划
| node01 | node02 | node03 |
|---|---|---|
| NameNode | NameNode | NameNode |
| JournalNode | JournalNode | JournalNode |
| DataNode | DataNode | DataNode |
| ZK | ZK | ZK |
| ResourceManager | ResourceManager | |
| NodeManager | NodeManager | NodeManager |
yarn-site.xml
<configuration>

    <property>
        <name>yarn.nodemanager.aux-services</name>
        <value>mapreduce_shuffle</value>
    </property>

    <!-- 启用resourcemanager ha -->
    <property>
        <name>yarn.resourcemanager.ha.enabled</name>
        <value>true</value>
    </property>

    <!-- 声明两台resourcemanager的地址 -->
    <property>
        <name>yarn.resourcemanager.cluster-id</name>
        <value>cluster-yarn1</value>
    </property>
    <!--指定resourcemanager的逻辑列表-->
    <property>
        <name>yarn.resourcemanager.ha.rm-ids</name>
        <value>rm1,rm2</value>
</property>
<!-- ========== rm1的配置 ========== -->
<!-- 指定rm1的主机名 -->
    <property>
        <name>yarn.resourcemanager.hostname.rm1</name>
        <value>node01</value>
</property>
<!-- 指定rm1的web端地址 -->
<property>
     <name>yarn.resourcemanager.webapp.address.rm1</name>
     <value>node01:8088</value>
</property>
<!-- 指定rm1的内部通信地址 -->
<property>
     <name>yarn.resourcemanager.address.rm1</name>
     <value>node01:8032</value>
</property>
<!-- 指定AM向rm1申请资源的地址 -->
<property>
     <name>yarn.resourcemanager.scheduler.address.rm1</name>
     <value>node01:8030</value>
</property>
<!-- 指定供NM连接的地址 -->
<property>
     <name>yarn.resourcemanager.resource-tracker.address.rm1</name>
     <value>node01:8031</value>
</property>
<!-- ========== rm2的配置 ========== -->
    <!-- 指定rm2的主机名 -->
    <property>
        <name>yarn.resourcemanager.hostname.rm2</name>
        <value>node02</value>
</property>
<property>
     <name>yarn.resourcemanager.webapp.address.rm2</name>
     <value>node02:8088</value>
</property>
<property>
     <name>yarn.resourcemanager.address.rm2</name>
     <value>node02:8032</value>
</property>
<property>
     <name>yarn.resourcemanager.scheduler.address.rm2</name>
     <value>node02:8030</value>
</property>
<property>
     <name>yarn.resourcemanager.resource-tracker.address.rm2</name>
     <value>node02:8031</value>
</property>

    <!-- 指定zookeeper集群的地址 -->
    <property>
        <name>yarn.resourcemanager.zk-address</name>
        <value>node01:2181,node02:2181,node03:2181</value>
    </property>

    <!-- 启用自动恢复 -->
    <property>
        <name>yarn.resourcemanager.recovery.enabled</name>
        <value>true</value>
    </property>

    <!-- 指定resourcemanager的状态信息存储在zookeeper集群 -->
    <property>
        <name>yarn.resourcemanager.store.class</name>     <value>org.apache.hadoop.yarn.server.resourcemanager.recovery.ZKRMStateStore</value>
</property>
<!-- 环境变量的继承 -->
 <property>
        <name>yarn.nodemanager.env-whitelist</name>
        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value>
    </property>

</configuration>- 分发配置文件
附加:HA的启动顺序
先在每台机器上都启动zkServer
bin/zkServer.sh start然后在每台机器上启动journalnode
hdfs --daemon start journalnode然后启动hdfs和yarn
HA一键启动脚本
#!/bin/bash
if [ $# -lt 1 ]
then
    echo "please input start | stop"
    exit ;
fi

case $1 in
"start")
        echo " =================== 启动 HA-hadoop集群 ==================="

        echo " ======== 启动 ZK ========"

        for i in node01 node02 node03
        do
            ssh $i "cd /opt/module/zookeeper-3.5.7/;
                    bin/zkServer.sh start;
                    hdfs --daemon start journalnode"
        done

        echo " ======== 启动 Hadoop ========"

        ssh node01 "cd /opt/module/hadoop-3.1.3/;
                    sbin/start-dfs.sh;
                    sbin/start-yarn.sh;
                    bin/mapred --daemon start historyserver"
;;
"stop")
        echo " =================== 关闭 HA-hadoop集群 ==================="

        echo " ======== 停止 ZK ========"
        for i in node01 node02 node03
        do
            ssh $i "cd /opt/module/zookeeper-3.5.7/;
                    bin/zkServer.sh stop;
                    hdfs --daemon stop journalnode"
        done

        echo " ======== 停止 Hadoop ========"

        ssh node01 "cd /opt/module/hadoop-3.1.3/;
                    sbin/stop-dfs.sh;
                    sbin/stop-yarn.sh;
                    bin/mapred --daemon stop historyserver"
;;
*)
    echo "Input Error..."
;;
esac
解决8485端口拒绝连接问题
core-site..xml
<property>
   <name>ipc.client.connect.max.retries</name>
   <value>100</value>
 </property>
 <property>
   <name>ipc.client.connect.retry.interval</name>
   <value>10000</value>
 </property>