用 Python 对比两个时间窗口,排查 5xx 上升
本节目录
假设 09:30 之后,监控显示 5xx 数量上升。先问两个问题:比例有没有一起上升,新增的失败集中在哪个接口? 这一节用合成日志把两个相邻窗口放在一起比较。这里的 5xx 是 HTTP 500 到 599。 HTTP 5xx 状态码定义
hwlog 0.1.0 的发布包含源码、wheel、README 和合成样例。 GitHub 源码 · v0.1.0 Release · 下载完整 ZIP
先对齐窗口和分母
基线窗口是 [09:00, 09:30),异常窗口是 [09:30, 10:00),时间都用 UTC。以相同方式筛选两份数据。每个窗口的 5xx 比例等于该窗口的 5xx 条数除以有效请求数。统计接口时继续使用「方法 + 路径」,再按 5xx 新增条数排序。
准备样例和脚本
在 0.1.0 发布包 中使用 examples/5xx.jsonl。下面是其中两条记录,完整的 50 行也可以用包里的 examples/make_examples.py 在空目录生成。
{"ts":"2026-11-19T09:00:00+00:00","method":"GET","path":"/api/items","status":200,"duration_ms":60}
{"ts":"2026-11-19T09:30:09+00:00","method":"GET","path":"/api/items","status":502,"duration_ms":60}
将下列代码保存为 compare_5xx.py。从发布包解压后可以直接运行 examples/compare_5xx.py,先按 README 在虚拟环境里安装自带的 wheel。
import argparse
from collections import Counter

from hwlog.log_cli import build_parser, parse_args, selected_rows, timestamp_arg
from hwlog.metrics import percent


def summarize(lines, args):
    counts = [Counter(), Counter()]
    failures = [Counter(), Counter()]
    skipped = Counter()
    for request in selected_rows(lines, args, skipped):
        window = 0 if request.ts < args.split else 1
        key = (request.method, request.path)
        counts[window][key] += 1
        if 500 <= request.status < 600:
            failures[window][key] += 1
    return counts, failures, skipped


def main(argv=None):
    parser = build_parser("比较分界点前后两个窗口的 5xx")
    parser.add_argument("--split", type=timestamp_arg, required=True, help="两个窗口的分界时刻")
    args = parse_args(parser, argv)
    if args.since is None or args.until is None or not args.since < args.split < args.until:
        parser.error("请指定 --since 和 --until,并使 --since < --split < --until")
    try:
        with args.input.open(encoding="utf-8") as log:
            counts, failures, skipped = summarize(log, args)
    except (OSError, UnicodeError) as error:
        parser.error(f"无法读取输入:{error}")

    for label, requests, failed in zip(("基线窗口", "异常窗口"), counts, failures, strict=True):
        total = sum(requests.values())
        errors = sum(failed.values())
        print(f"{label}:{total} 条请求,{errors} 条 5xx,5xx 比例 {percent(errors / total if total else None)}")

    delta = failures[1] - failures[0]
    print(f"整份输入跳过:{sum(skipped.values())}")
    print("5xx 增量排行:")
    for (method, path), increase in delta.most_common(5):
        key = (method, path)
        print(f"  {method} {path}  {failures[0][key]} → {failures[1][key]}(+{increase})")


if __name__ == "__main__":
    main()
python examples/compare_5xx.py examples/5xx.jsonl --since 2026-11-19T09:00:00Z --split 2026-11-19T09:30:00Z --until 2026-11-19T10:00:00Z
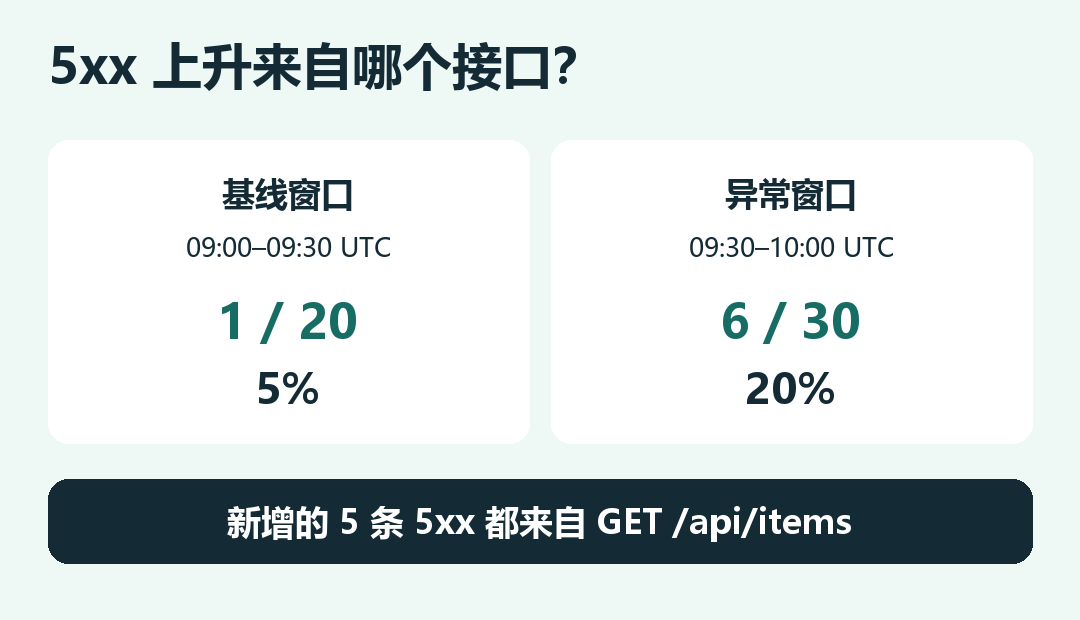
基线窗口:20 条请求,1 条 5xx,5xx 比例 5.00%
异常窗口:30 条请求,6 条 5xx,5xx 比例 20.00%
整份输入跳过:0
5xx 增量排行:
  GET /api/items  1 → 6(+5)
读完报表后查什么
异常窗口多了 10 条请求,5xx 比例却从 5% 升到 20%,上升 15 个百分点。新增的 5 条 5xx 全部集中在 GET /api/items。从样例行还能看到这些失败是 502。真实排查时,可以优先在同一时间窗口找出该接口的失败请求,再用请求 ID 对照网关与上游服务日志,核对超时、连接错误或发布变更等线索。
练习时把异常窗口里一条 GET /health 的 200 改成 503。重跑后,异常窗口应有 7 条 5xx,增量排行应多出 GET /health 的 +1。想一想,如果只看错误条数,什么时候会把流量增长误读成服务退化。 继续定位慢接口