用 Python 统计日志错误率、P95 和热门接口
本节目录
一份请求报表至少要回答三件事:这个窗口里多少请求失败、慢请求大概有多慢、哪些接口值得先看。我们沿用上一节的命令行筛选,用同一批请求计算错误率、P95 耗时和热门请求分组。 获取日志样例和参数解析脚本
指标口径先写清楚
- 错误率等于 4xx 和 5xx 请求数之和,除以窗口内的有效请求数。另列 5xx 比例,便于观察服务端错误。
- P95只使用带有效
duration_ms的请求。样本从小到大排序,取从 1 开始的第ceil(0.95 × n)位。本节采用最邻近秩法,横向比较时应使用相同的分位数算法。 - Top N按
(方法, 路径)的访问次数排序,查询参数在上一节的解析器里已去除。
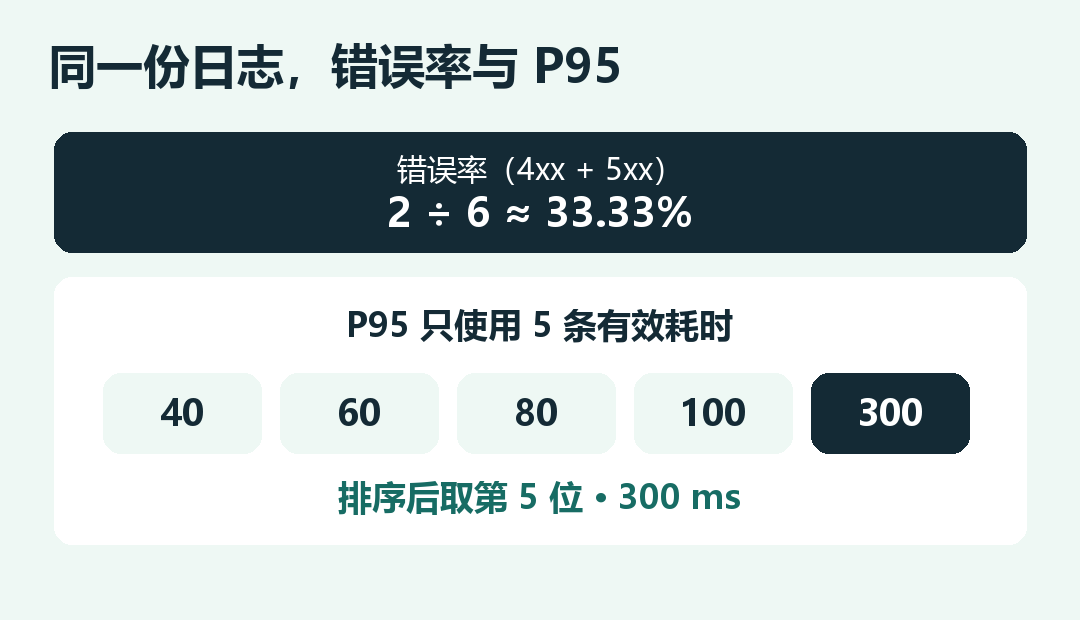
样例窗口里共有 6 条有效请求,其中 1 条是 404、1 条是 502,所以错误率是 2 ÷ 6。有一条 200 请求缺少耗时,它仍计入请求总数。剩下的耗时从小到大是 40、60、80、100、300 毫秒,P95 取第 5 位,也就是 300 毫秒。小样本的 P95 容易受最大值影响,报表同时打印耗时样本数。
写出统计脚本
将代码保存为 metrics.py,和上一节的 log_cli.py、access.jsonl 放在同一目录。
import argparse
import math
from collections import Counter

from log_cli import build_parser, parse_args, selected_rows


def positive_int(text):
    try:
        value = int(text)
    except ValueError as error:
        raise argparse.ArgumentTypeError("请传入正整数") from error
    if value < 1:
        raise argparse.ArgumentTypeError("请传入正整数")
    return value


def metrics_parser(description):
    parser = build_parser(description)
    parser.add_argument("--top", type=positive_int, default=5, help="列出前 N 个请求分组")
    return parser


def latency_ms(value):
    if type(value) not in (int, float):
        return None
    try:
        number = float(value)
    except OverflowError:
        return None
    return number if math.isfinite(number) and number >= 0 else None


def percentile_95(samples):
    if not samples:
        return None
    ordered = sorted(samples)
    rank = (95 * len(ordered) + 99) // 100
    return ordered[rank - 1]


def build_report(lines, args):
    skipped = Counter()
    endpoints = Counter()
    latencies = []
    client_errors = server_errors = 0
    for row in selected_rows(lines, args, skipped):
        endpoints[row["method"], row["path"]] += 1
        status = row["status"]
        client_errors += 400 <= status < 500
        server_errors += 500 <= status < 600
        duration = latency_ms(row.get("duration_ms"))
        if duration is not None:
            latencies.append(duration)

    total = sum(endpoints.values())
    return {
        "requests": total,
        "client_errors": client_errors,
        "server_errors": server_errors,
        "error_rate": (client_errors + server_errors) / total if total else None,
        "server_error_rate": server_errors / total if total else None,
        "latency_samples": len(latencies),
        "p95_ms": percentile_95(latencies),
        "skipped": dict(skipped),
        "top": [
            {"method": method, "path": path, "requests": count}
            for (method, path), count in endpoints.most_common(args.top)
        ],
    }


def percent(rate):
    return f"{rate:.2%}" if rate is not None else "无数据"


def format_report(report):
    p95 = report["p95_ms"]
    latency_text = f"{p95:g} ms" if p95 is not None else "无有效样本"
    lines = [
        f"有效请求:{report['requests']}",
        f"整份输入跳过:{sum(report['skipped'].values())}",
        f"错误率(4xx + 5xx):{percent(report['error_rate'])}",
        f"5xx 比例:{percent(report['server_error_rate'])}",
        f"P95:{latency_text}({report['latency_samples']} 条耗时样本)",
        "访问量排行(方法 + 路径):",
    ]
    for item in report["top"]:
        lines.append(f"  {item['method']} {item['path']}  {item['requests']}")
    return "\n".join(lines)


def main(argv=None):
    parser = metrics_parser("统计错误率、P95 和热门请求分组")
    args = parse_args(parser, argv)
    try:
        with args.input.open(encoding="utf-8") as log:
            report = build_report(log, args)
    except (OSError, UnicodeError) as error:
        parser.error(f"无法读取输入:{error}")
    print(format_report(report))


if __name__ == "__main__":
    main()
运行下面的命令。这里省略了 --method,因此 GET 和 POST 都会进入统计。
python metrics.py access.jsonl --since 2026-11-19T16:00:00Z --until 2026-11-19T17:00:00Z --top 2
有效请求:6
整份输入跳过:1
错误率(4xx + 5xx):33.33%
5xx 比例:16.67%
P95:300 ms(5 条耗时样本)
访问量排行(方法 + 路径):
  GET /search  3
  GET /api/items  2
没有符合筛选的请求时,错误率显示「无数据」。有请求但没有有效耗时样本时,P95 显示「无有效样本」。代码仍逐行读取原始日志,精确计算 P95 时会保留有效耗时值并排序。数据量大时,耗时样本和不同的请求分组都会增加内存占用。
动手核对
在命令末尾加 --method GET,预期有效请求变为 5 条,错误率为 40%,P95 仍为 300 毫秒,耗时样本数变为 4。再用 percentile_95(list(range(10, 201, 10))) 验证 20 个样本时取第 19 位,结果是 190。 继续导出 CSV 和 JSON