用 Python 字典和集合按请求方法与路径分组
本节目录
访问日志里,两条请求可能都打到 /search,却代表不同操作。比如 GET /search 查询结果,POST /search 提交一组搜索条件。上一节只按路径计数,本节改成按 HTTP 方法和路径 一起计数,同时统计每种方法访问过多少个不同路径。 回顾读日志的第一份脚本
先定分组规则
我们把 (method, path) 这个二元组作为计数器的键。GET /search?q=python 和 GET /search?q=go 去掉查询参数后,都归入 ("GET", "/search")。同一路径上的 POST /search 则是另一个键。这样既能合并查询参数不同的记录,也能保留 HTTP 方法的区别。
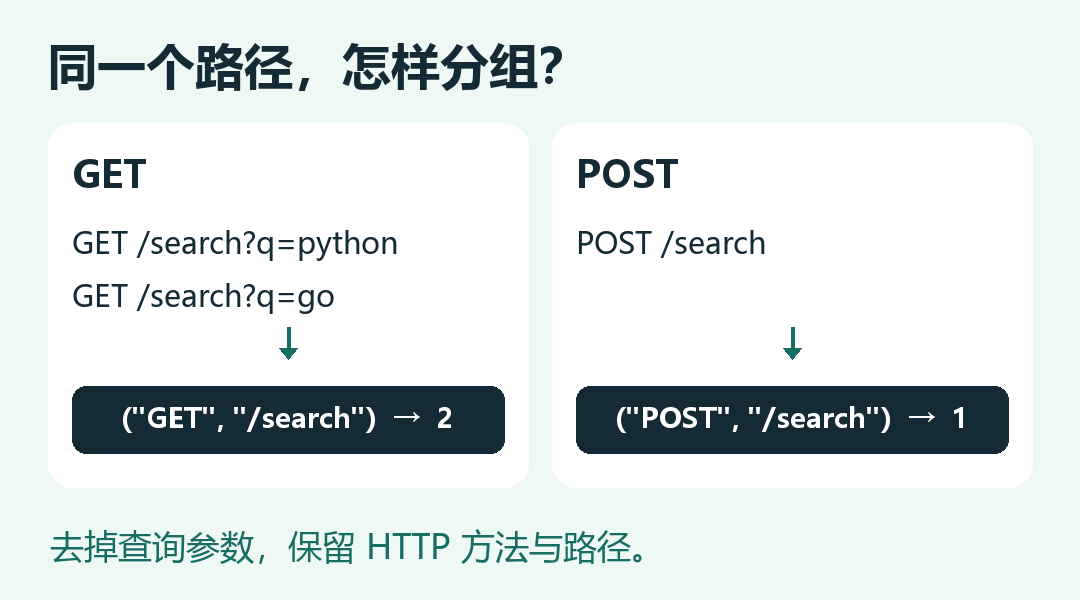
方法和路径组合起来,回答的是「每类请求来了多少次」。如果问题换成「GET 访问了多少个不同的路径」,就用字典把每种方法对应到一个集合。add("/search") 调用两次,集合里仍然只有一个 /search。 Python 集合与字典 · Counter 文档
样例和完整代码
把下面的内容保存为 access.log。它沿用前一节的样例,只增加了一条 POST /search 请求。
192.0.2.10 - - [19/Nov/2026:10:00:01 +0800] "GET / HTTP/1.1" 200 512
192.0.2.11 - - [19/Nov/2026:10:00:02 +0800] "GET /search?q=python HTTP/1.1" 200 1024
192.0.2.12 - - [19/Nov/2026:10:00:03 +0800] "GET /search?q=go HTTP/1.1" 200 980
192.0.2.13 - - [19/Nov/2026:10:00:04 +0800] "GET /old-page HTTP/1.1" 404 128
192.0.2.14 - - [19/Nov/2026:10:00:05 +0800] "GET /api/items HTTP/1.1" 502 64
192.0.2.15 - - [19/Nov/2026:10:00:06 +0800] "POST /search HTTP/1.1" 201 300
这行模拟了一条不完整的日志
把脚本保存为同目录下的 group.py,运行 python group.py,或者使用系统中的 python3 命令。代码只用标准库。
from collections import Counter
from pathlib import Path


def parse_request(line):
    parts = line.split('"', 2)
    if len(parts) != 3:
        return None

    request_fields = parts[1].split()
    response_fields = parts[2].split(maxsplit=1)
    if len(request_fields) != 3 or not response_fields:
        return None

    method, target, _ = request_fields
    status = response_fields[0]
    if not target.startswith("/") or len(status) != 3 or not status.isascii() or not status.isdigit():
        return None

    status_code = int(status)
    if not 100 <= status_code <= 599:
        return None

    return method, target.split("?", 1)[0], status_code


def main():
    statuses = Counter()
    endpoints = Counter()
    paths_by_method = {}
    skipped = 0
    sample = Path(__file__).with_name("access.log")

    with sample.open(encoding="utf-8") as log:
        for line in log:
            request = parse_request(line)
            if request is None:
                skipped += 1
                continue
            method, path, status = request
            statuses[status] += 1
            endpoints[method, path] += 1
            paths_by_method.setdefault(method, set()).add(path)

    print(f"有效请求:{sum(statuses.values())}")
    print(f"跳过记录:{skipped}")
    print(f"404:{statuses[404]}")
    print(f"5xx:{sum(count for status, count in statuses.items() if 500 <= status < 600)}")
    print("访问量前 5(方法 + 路径):")
    for (method, path), count in endpoints.most_common(5):
        print(f"  {method} {path}  {count}")
    print("各方法访问了多少种路径:")
    for method in sorted(paths_by_method):
        print(f"  {method}  {len(paths_by_method[method])}")


if __name__ == "__main__":
    main()
对照运行结果
有效请求:6
跳过记录:1
404:1
5xx:1
访问量前 5(方法 + 路径):
  GET /search  2
  GET /  1
  GET /old-page  1
  GET /api/items  1
  POST /search  1
各方法访问了多少种路径:
  GET  4
  POST  1
有效请求是 6 条,GET 有 5 条请求,但只访问了 4 种路径。区别来自 GET /search 出现两次。代码里 paths_by_method.setdefault(method, set()) 首次见到某个方法就为它放入一个空集合,之后取出同一个集合并加入路径。
选择分组键会改变你能看到的问题。如果把方法和状态码也放在一起,可以追踪 POST /search 的失败次数;当前的 statuses 只回答整份日志有多少 404 和 5xx。先确定想回答的问题,再决定需要保存哪一组键。
动手练习
复制一条 GET /search,随便替换查询参数。GET /search 应当增加到 3 次,GET 的不同路径数仍然是 4。然后再添加一条 POST /api/items,POST 的不同路径数应当增加到 2。
下一节会保留这份输出,把实现拆成独立函数,让几条手写日志就能验证统计行为。 继续阅读函数拆分