用 Python 逐行读取大日志,并实测内存差异
本节目录
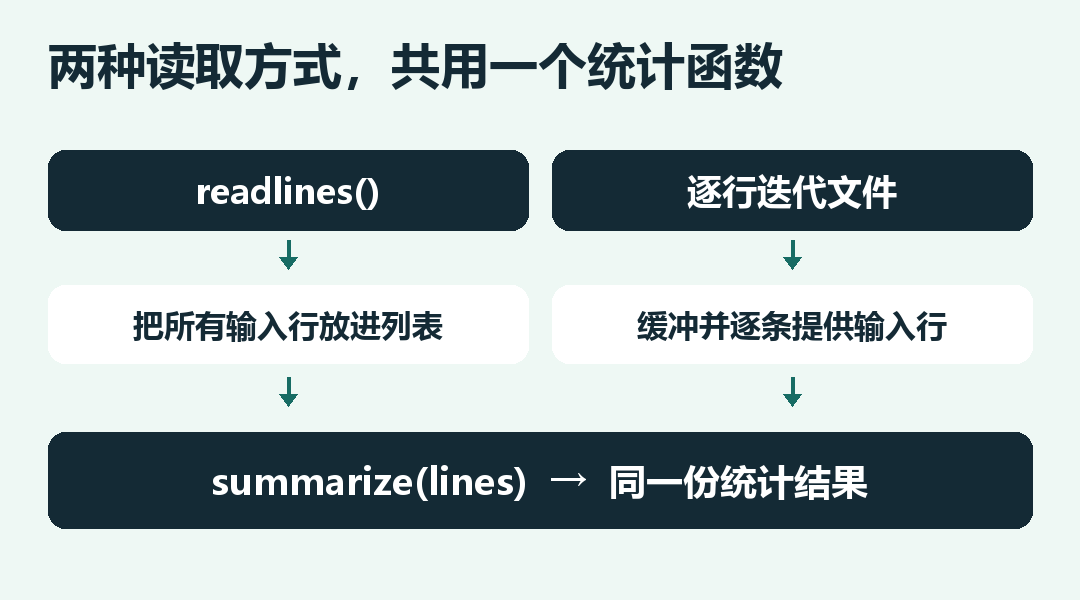
读一份几百兆的日志,需要把几百兆文本都放进 Python 内存吗?上节的 summarize(lines) 接受任何可迭代的日志行,因此这一节可以拿同一个统计函数做对照:一次把文件读成列表,另一次直接迭代文件。比较内存之前,先确认两种读法输出了相同的统计结果。 回顾坏记录处理与验证脚本
对照只改输入的读法
log.readlines()先把各行放进一个列表。开始聚合时,列表里的字符串仍在内存里。for line in log由文件迭代器陆续提供内容。文件对象内部会做缓冲,应用无需积攒所有行。
两种方法都调用上一节的 summarize。实验里准备 50,000 条日志,交替访问两个路径,故意把分组数固定为 2。这样看到的差异主要来自读取阶段。
跑一次可复现的内存实验
把以下代码保存为 stream.py,与上一节的 validate.py 放在同一个目录。运行 python stream.py。脚本会生成一个名为 generated-benchmark.jsonl 的合成日志;再次运行前先移走这一个样例文件。脚本遇到同名文件就退出,避免覆盖现有数据。
import json
import tracemalloc
from pathlib import Path

from validate import summarize


def make_sample(destination, rows=50_000):
    with destination.open("x", encoding="utf-8") as log:
        for index in range(rows):
            row = {
                "ts": "2026-11-19T16:12:00Z",
                "method": "GET",
                "path": ("/search", "/api/items")[index % 2],
                "status": 200,
            }
            log.write(json.dumps(row) + "\n")


def measure(source, *, read_all):
    tracemalloc.start()
    try:
        with source.open(encoding="utf-8") as log:
            lines = log.readlines() if read_all else log
            report = summarize(lines)
        _, peak = tracemalloc.get_traced_memory()
    finally:
        tracemalloc.stop()
    return report, peak


def main():
    source = Path(__file__).with_name("generated-benchmark.jsonl")
    try:
        make_sample(source)
    except FileExistsError:
        raise SystemExit("样例文件已存在。请先移走 generated-benchmark.jsonl 再运行。") from None

    buffered, buffered_peak = measure(source, read_all=True)
    streamed, streamed_peak = measure(source, read_all=False)
    if buffered != streamed:
        raise RuntimeError("两种读法的统计结果不一致")

    endpoints, skipped = streamed
    print(f"有效请求:{sum(endpoints.values())},跳过:{sum(skipped.values())}")
    print(f"分组数:{len(endpoints)}")
    print(f"readlines() 的 Python 分配峰值:{buffered_peak / 1024:.1f} KiB")
    print(f"逐行读取的 Python 分配峰值:{streamed_peak / 1024:.1f} KiB")


if __name__ == "__main__":
    main()
下面是编辑验证时的一次实测。前两行在相同输入下应一致,内存数字会随 Python 版本、平台和进程状态变化。
有效请求:50000,跳过:0
分组数:2
readlines() 的 Python 分配峰值:6921.4 KiB
逐行读取的 Python 分配峰值:35.3 KiB
tracemalloc 测的是开启追踪后 Python 内存分配的峰值,和操作系统看到的进程 RSS 是两个指标。本实验在生成合成数据之后才开始测量,并在两种读法之间分别启动和结束追踪。 Python tracemalloc 文档
逐行读取还有哪些内存开销
这个工具仍会保存每个不同的 (method, path) 分组、跳过原因计数,以及读文件和解析当前行需要的内存。两条路径时分组只有两个键。如果路径含大量订单编号,分组本身就可能增长。生产报表需要逐条明细时,可以写入磁盘或数据库;只看趋势时,通常可以按路由模板聚合,例如用 /orders/{id} 表示这类路由。
练习时,在 make_sample 里把路径替换成 f"/orders/{index}",移走原合成样例再跑。分组数将变成 50,000,可以观察逐行读取一列的内存为什么也会上升。
第二章到这里完成。现在脚本可以解析带时区的 JSON Lines、解释为什么跳过记录,并以逐行方式处理大文件。第三章会用 argparse 传入文件路径和时间范围。